

В Android 17 и более поздних версиях поддерживается менеджер нейропроцессора (NPU) (com.android.npumanager), который координирует распределение и планирование ресурсов NPU между системными сервисами и рабочими нагрузками приложений. Перенос арбитража ресурсов с пользовательских демонов поставщика на платформу Android позволяет менеджеру NPU повысить предсказуемость, предотвратить нехватку ресурсов, управлять температурными границами и повысить общую производительность устройства.
Предпосылки и мотивация
До появления NPU Manager приложения и системные модули отправляли рабочие нагрузки напрямую драйверам поставщиков или проприетарным сервисам. У этого подхода было несколько недостатков:
- Неэффективная конкуренция за ресурсы. Тяжелые рабочие нагрузки машинного обучения (например, механизмы вывода больших языковых моделей или системы машинного зрения на устройстве) напрямую конкурировали с другими высокоприоритетными системами за ограниченные ресурсы NPU (например, SRAM, память весов и каналы выполнения).
- Нестабильность системы. Несогласованные рабочие нагрузки могут привести к перегреву, ошибкам страниц памяти или запуску демона LMKD, если требования превышают возможности оборудования.
- Неэффективная приоритизация. Системный сервер не может корректировать приоритет NPU в ответ на смену контекста, например когда фоновая задача загружает массивную модель, а на переднем плане активен чувствительный к задержкам конвейер камеры или помощник пользователя.
Менеджер NPU решает эти проблемы, выступая в качестве системного арбитра, который контролирует загрузку моделей и динамически корректирует приоритеты выполнения на основе текущего состояния устройства и приложений.
Архитектура системы
Менеджер NPU реализован как системный сервис npu, работающий в среде Android. Менеджер NPU изолирует высокоуровневую координацию правил планирования от низкоуровневой реализации драйвера поставщика.
На схеме ниже показаны уровни среды NPU Manager.
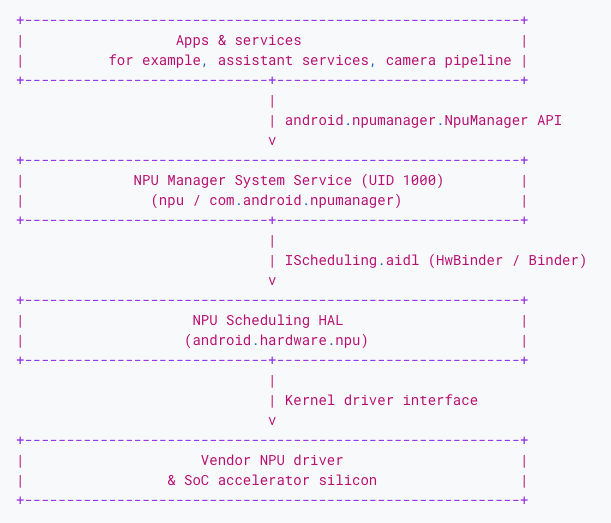
Рисунок 1. Слои среды NPU Manager.
Основные компоненты
- Клиент Framework API (
android.npumanager.NpuManager). Точка входа, используемая клиентами для запроса резервирования загрузки модели. - Системная служба (
npu). Системная служба, которая контролирует одобрение загрузки модели и управляет командами вытеснения на основе правил приоритета планирования. - NPU Scheduling HAL (
android.hardware.npu). Интерфейс на основе AIDL, который передает обратные вызовы приоритетов приложений Android между фреймворком и драйвером. - Драйвер поставщика. Драйвер низкого уровня, который управляет блоками выполнения оборудования и реализует механизмы приоритезации низкого уровня.
SDK и API фреймворка
Прежде чем вызывать низкоуровневые библиотеки нейронных сетей или загружать файлы моделей, клиенты фреймворка должны взаимодействовать с сервисом NpuManager. Для этого клиенты сначала определяют запрос на загрузку модели, а затем выполняют запрос и процесс утверждения.
Запрос на загрузку модели
Запрос на загрузку модели представлен элементом ModelLoadRequest. Этот объект содержит:
- Уникальный идентификатор запроса
- Примерный класс размера модели, например
NPU_MODEL_SIZE_LESS_THAN_1GBилиNPU_MODEL_SIZE_GREATER_THAN_2G. - Приоритет, например
NPU_MODEL_PRIORITY_BACKGROUND,NPU_MODEL_PRIORITY_NORMALилиNPU_MODEL_PRIORITY_OPPORTUNISTIC.
В примере кода ниже создается объект ModelLoadRequest с ограничением размера более 2 ГБ и нормальным приоритетом выполнения:
ModelLoadRequest request = new ModelLoadRequest.Builder(requestId)
        .setSize(NPU_MODEL_SIZE_GREATER_THAN_2G)
        .setPriority(NPU_MODEL_PRIORITY_NORMAL)
        .build();
Процесс запроса и одобрения
Клиенты вызывают requestCanLoadModel асинхронно:
npuManager.requestCanLoadModel(request, callback, executor);
Когда ресурсы NPU доступны, фреймворк отвечает, используя ModelLoadRequestCallback со следующими событиями:
onCanLoadModel(request, status, listener): срабатывает, когда запрос одобрен. Клиент получает токенNpuManager.ModelLoadStatusListener. После того как клиент полностью загрузит модель в память драйвера, он должен вызвать функциюlistener.notifyModelLoaded(request).onRequestUnloadModel(request)илиonRequestUnloadModel(request, reason): срабатывает, когда система испытывает нехватку ресурсов (например, при входящем запросе на переднем плане или резком повышении температуры) и требует, чтобы клиент освободил свою модель. После возврата ресурсов NPU клиент вызываетlistener.notifyModelUnloaded(request).onModelLoadRequestComplete(request, status)– сообщает клиенту об окончательных изменениях жизненного цикла запроса, например об отмене.
Клиенты могут отменять ожидающие приглашения с помощью cancelModelLoad(request).
Интеграция HAL и поставщика
Чтобы поддерживать менеджер NPU, реализации поставщиков для определенных устройств должны соответствовать android.hardware.npu интерфейсам сервисов AIDL.
Настройка расписания
Система передает приоритет приложения с помощью SchedulingConfig AIDL, структуры SchedulingConfig AIDL, определенной в IScheduling.aidl:
package android.hardware.npu;

@VintfStability
parcelable SchedulingConfig {
    int minPriority;
    int maxPriority;
    int uid;
    int appPriority;
    boolean hasDirectAccess;
    boolean canAttributeOtherUid;
}
Менеджер по вопросам национальной политики и управления координирует приоритеты. Например, если фоновое приложение отправляет задание с высоким приоритетом, приоритет снижается, чтобы не мешать работе графики на переднем плане.
Статус задачи и профилирование
Драйверы поставщиков должны сообщать менеджеру о статусе жизненного цикла групп выполнения NPU. WorkInfo отслеживает задачи (определенные в
WorkInfo.aidl):
package android.hardware.npu;

import android.hardware.npu.NpuUuid;

@VintfStability
parcelable WorkInfo {
    int id;
    @nullable NpuUuid groupId;
    int uid;
    int debugPid;
    int originalUid;
    @nullable String debugFeatureId;
    int jobPriority;
    int effectivePriority;
    long timestampMs;
    int deviceNumber;
}
Устранение дребезга событий
В рамках планирования поддерживается устранение дребезга событий с помощью параметра debounce_duration_ms в регистрации обратного вызова планирования.
Это позволяет избежать переполнения журнала и подавляет быстрые уведомления, например последовательные события начала и окончания для повторяющихся моделей.
Статусы жизненного цикла обратного вызова передаются следующим образом:
onWorkRequested: поставщик добавил рабочую нагрузку в очередь.onWorkStarted: начало выполнения рабочей нагрузки.NPU_START_REASON_INITIAL– первый запуск.NPU_START_REASON_RESUMED: выполнение возобновлено после прерывания.
onWorkEnded: выполнение рабочей нагрузки завершено.NPU_END_REASON_COMPLETED– успешное завершение запуска.NPU_END_REASON_CANCELLED_USER: отменено клиентом.NPU_END_REASON_CANCELLED_SYSTEM: вытеснено системным правилом.NPU_END_REASON_FAILED– ошибка выполнения или сбой драйвера.NPU_END_REASON_PAUSED– временно приостановлено для выполнения более приоритетных задач.
Готовность и тестирование устройств
Убедитесь, что эти конфигурации настроены, прежде чем проверять состояние устройства.
Декларации приложений
Клиенты, которым требуется приоритет планирования NPU, должны объявить аппаратную функцию NPU в своем файле AndroidManifest.xml:
<uses-feature android:name="android.hardware.npu" android:required="false" />
Для моделей, развернутых на более новых поколениях партнерского оборудования, эта декларация может быть необходима для оптимального создания движка.
Интеграционное тестирование VTS
Реализации NPU HAL можно проверить с помощью функционального тестирования VTS, например VtsHalNpuSchedulingTargetTest.