

В Android есть эталонная реализация всех компонентов, необходимых для внедрения платформы виртуализации Android. В настоящее время эта реализация ограничена ARM64. На этой странице описана архитектура фреймворка.
Фон
Архитектура Arm поддерживает до четырех уровней исключений, где уровень 0 (EL0) – наименее привилегированный, а уровень 3 (EL3) – наиболее. Самая большая часть базы кода Android (все компоненты пространства пользователя) выполняется на уровне EL0. Остальная часть того, что обычно называют Android, – это ядро Linux, которое работает на уровне EL1.
Уровень EL2 позволяет внедрить гипервизор, который изолирует память и устройства в отдельные pVM на уровнях EL1/EL0, обеспечивая надежную конфиденциальность и целостность.
Гипервизор
Защищенная виртуальная машина KVM создана на основе гипервизора Linux KVM, который был расширен за счет возможности ограничивать доступ к полезным нагрузкам, выполняемым в гостевых виртуальных машинах, помеченных как "защищенные" во время создания.
KVM/arm64 поддерживает разные режимы выполнения в зависимости от доступности определенных функций процессора, а именно расширений хоста виртуализации (VHE) (ARMv8.1 и более поздние версии). В одном из этих режимов, обычно называемом режимом без VHE, код гипервизора извлекается из образа ядра во время загрузки и устанавливается на уровне EL2, а само ядро выполняется на уровне EL1. Хотя компонент EL2 в KVM является частью базы кода Linux, он небольшой и отвечает за переключение между несколькими EL1. Компонент гипервизора компилируется с Linux, но находится в отдельном выделенном разделе памяти образа vmlinux. pKVM использует эту архитектуру, расширяя код гипервизора новыми функциями, которые позволяют накладывать ограничения на ядро хоста Android и пользовательское пространство, а также ограничивать доступ хоста к гостевой памяти и гипервизору.
Модули поставщика pKVM
Модуль поставщика pKVM – это модуль, содержащий функции, которые зависят от устройства, например драйверы блока управления памятью ввода-вывода (IOMMU). Эти модули позволяют переносить в pKVM функции безопасности, требующие доступа на уровне исключения 2 (EL2).
Чтобы узнать, как реализовать и загрузить модуль поставщика pKVM, ознакомьтесь со статьей Как реализовать модуль поставщика pKVM.
Процедура загрузки
На рисунке ниже показана процедура загрузки pKVM.

- Инициализация. Загрузчик операционной системы входит в общее ядро на уровне EL2. Затем доверенный код ядра на уровнях EL2 и EL1 инициализирует pKVM и его модули. На этом этапе EL1 доверяет EL2, поэтому ненадежный код не выполняется.
- Понижение привилегий ядра. Универсальное ядро определяет, что оно работает на уровне EL2, и понижает свои привилегии до уровня EL1. pKVM и его модули продолжают работать на уровне EL2.
- Во время выполнения. Универсальное ядро загружается в обычном режиме, загружая все необходимые драйверы устройств, пока не достигнет пользовательского пространства. На этом этапе pKVM уже работает и управляет таблицами страниц второго уровня.
Процедура загрузки доверяет загрузчику операционной системы проверку и поддержание целостности образа ядра на этапе инициализации. После того как ядро лишено привилегий, гипервизор больше не считает его доверенным и отвечает за собственную защиту, даже если ядро скомпрометировано.
Ядро Android и гипервизор в одном двоичном образе позволяют им обмениваться данными через тесно связанный интерфейс. Такая тесная связь гарантирует атомарное обновление двух компонентов, что позволяет не поддерживать стабильность интерфейса между ними и обеспечивает большую гибкость без ущерба для долгосрочной поддержки. Тесная связь также позволяет оптимизировать производительность, когда оба компонента могут взаимодействовать, не влияя на гарантии безопасности, предоставляемые гипервизором.
Кроме того, использование GKI в экосистеме Android автоматически позволяет развертывать гипервизор pKVM на устройствах Android в том же двоичном файле, что и ядро.
Защита доступа к памяти ЦП
В архитектуре Arm блок управления памятью (MMU) разделен на два независимых этапа, каждый из которых можно использовать для преобразования адресов и контроля доступа к разным частям памяти. MMU первого этапа управляется EL1 и позволяет выполнять перевод адресов первого уровня. MMU первого уровня используется Linux для управления виртуальным адресным пространством, предоставляемым каждому процессу пользовательского пространства, и собственным виртуальным адресным пространством.
MMU второго этапа управляется EL2 и позволяет применить второй перевод адресов к выходному адресу MMU первого этапа, в результате чего получается физический адрес (PA). Перевод второго этапа может использоваться гипервизорами для управления доступом к памяти и ее преобразования для всех гостевых виртуальных машин. Как показано на рисунке 2, если оба этапа преобразования включены, выходной адрес первого этапа называется промежуточным физическим адресом (IPA). Примечание. Виртуальный адрес (VA) преобразуется в IPA, а затем в PA.

Исторически KVM работает с включенным преобразованием второго уровня при запуске гостевых систем и с отключенным преобразованием второго уровня при запуске хост-ядра Linux. Такая архитектура позволяет запросам на доступ к памяти от MMU первого уровня хоста проходить через MMU второго уровня, что дает хосту неограниченный доступ к страницам памяти гостевой ОС. С другой стороны, pKVM обеспечивает защиту второго уровня даже в контексте хоста и возлагает на гипервизор ответственность за защиту страниц памяти гостевой ОС вместо хоста.
KVM в полной мере использует преобразование адресов на втором этапе, чтобы реализовать сложные сопоставления IPA/PA для гостей, которые создают иллюзию непрерывной памяти для гостей, несмотря на физическую фрагментацию. Однако использование MMU второго уровня для хоста ограничено только контролем доступа. Хост этапа 2 сопоставляется с идентификатором, поэтому непрерывные области памяти в пространстве IPA хоста также непрерывны в пространстве PA. Эта архитектура позволяет использовать большие сопоставления в таблице страниц и, следовательно, снижает нагрузку на буфер ассоциативной трансляции (TLB). Поскольку сопоставление идентификационной информации может быть проиндексировано PA, хост этапа 2 также используется для отслеживания владельца страницы непосредственно в таблице страниц.
Защита прямого доступа к памяти (DMA)
Как уже было сказано, удаление сопоставления гостевых страниц с хостом Linux в таблицах страниц ЦП – это необходимый, но недостаточный шаг для защиты гостевой памяти. pKVM также должна защищать от доступа к памяти, выполняемого устройствами с поддержкой DMA под управлением ядра хоста, и от атак DMA, инициированных вредоносным хостом. Чтобы предотвратить доступ такого устройства к гостевой памяти, pKVM требует наличия аппаратного блока управления памятью ввода-вывода (IOMMU) для каждого устройства с поддержкой DMA в системе, как показано на рисунке 3.

Как минимум, оборудование IOMMU предоставляет средства для предоставления и отзыва доступа для чтения и записи для устройства к физической памяти с точностью до страницы. Однако это аппаратное обеспечение IOMMU ограничивает использование устройств в pVM, поскольку они предполагают сопоставление идентификаторов на этапе 2.
Чтобы обеспечить изоляцию между виртуальными машинами, транзакции памяти, созданные от имени разных объектов, должны быть различимы для IOMMU, чтобы для преобразования можно было использовать соответствующий набор таблиц страниц.
Кроме того, уменьшение количества кода, относящегося к SoC, на уровне EL2 является ключевой стратегией для уменьшения общей доверенной вычислительной базы (TCB) pKVM и противоречит включению драйверов IOMMU в гипервизор. Чтобы устранить эту проблему, хост на EL1 отвечает за вспомогательные задачи управления IOMMU, такие как управление питанием, инициализация и, при необходимости, обработка прерываний.
Однако передача хосту контроля над состоянием устройства накладывает дополнительные требования к программному интерфейсу аппаратного обеспечения IOMMU, чтобы гарантировать, что проверки разрешений не могут быть обойдены другими средствами, например, после сброса устройства.
Стандартным и хорошо поддерживаемым IOMMU для устройств Arm, который позволяет выполнять как изоляцию, так и прямое назначение, является архитектура Arm System Memory Management Unit (SMMU). Эта архитектура является рекомендуемым решением.
Право собственности на воспоминания
При загрузке предполагается, что вся память, не относящаяся к гипервизору, принадлежит хосту и отслеживается гипервизором как таковая. При создании pVM хост передает ей страницы памяти, чтобы она могла загрузиться, а гипервизор передает право собственности на эти страницы от хоста к pVM. Таким образом, гипервизор устанавливает ограничения контроля доступа в таблице страниц второго уровня хоста, чтобы предотвратить повторный доступ к страницам и обеспечить конфиденциальность гостя.
Обмен данными между хостом и гостями осуществляется с помощью контролируемого доступа к памяти. Гостевые ОС могут делиться некоторыми своими страницами с хостом, используя гипервызов, который указывает гипервизору переназначить эти страницы в таблице страниц второго уровня хоста. Аналогичным образом обмен данными между хостом и TrustZone осуществляется с помощью операций совместного использования и/или предоставления памяти, которые тщательно отслеживаются и контролируются pKVM с использованием спецификации Firmware Framework for Arm (FF-A).
Поскольку требования к памяти pVM могут меняться со временем, предоставляется гипервызов, который позволяет передать право собственности на указанные страницы, принадлежащие вызывающему объекту, обратно хосту. На практике этот гипервызов используется с протоколом virtio balloon, чтобы разрешить VMM запрашивать память у pVM, а pVM – уведомлять VMM об освобожденных страницах контролируемым образом.
Гипервизор отслеживает, кому принадлежат все страницы памяти в системе и предоставляются ли они другим объектам. Большая часть информации о состоянии отслеживается с помощью метаданных, прикрепленных к таблицам страниц второго этапа хоста и гостей. Для этого используются зарезервированные биты в записях таблицы страниц (PTE), которые, как следует из их названия, предназначены для использования программным обеспечением.
Хост должен убедиться, что он не пытается получить доступ к страницам, которые стали недоступны из-за гипервизора. Незаконный доступ к хосту приводит к тому, что гипервизор внедряет в хост синхронное исключение, которое может привести к тому, что ответственная задача пользовательского пространства получит сигнал SEGV или произойдет сбой ядра хоста. Чтобы предотвратить случайный доступ, страницы, переданные гостевым ОС, не могут быть заменены или объединены ядром хоста.
Обработка прерываний и таймеры
Прерывания – важная часть взаимодействия гостевой ОС с устройствами и обмена данными между процессорами, где межпроцессорные прерывания (IPI) являются основным механизмом связи. Модель KVM предполагает делегирование всех функций управления виртуальными прерываниями хосту на уровне EL1, который в этом случае выступает в качестве ненадежной части гипервизора.
pKVM предлагает полную эмуляцию контроллера Generic Interrupt Controller версии 3 (GICv3) на основе существующего кода KVM. Таймер и IPI обрабатываются в рамках этого ненадежного кода эмуляции.
Поддержка GICv3
Интерфейс между EL1 и EL2 должен обеспечивать видимость полного состояния прерывания для хоста EL1, включая копии регистров гипервизора, связанных с прерываниями. Обычно это достигается с помощью областей общей памяти, по одной на каждый виртуальный ЦП.
Код поддержки времени выполнения системного регистра можно упростить, чтобы он поддерживал только регистр прерываний, сгенерированных программным обеспечением (SGIR), и регистр деактивации прерываний (DIR). Архитектура требует, чтобы эти регистры всегда перехватывались на EL2, в то время как другие перехваты до сих пор были полезны только для устранения ошибок. Все остальное обрабатывается на уровне оборудования.
На стороне MMIO все эмулируется на уровне EL1 с использованием всей текущей инфраструктуры KVM. Наконец, Wait for Interrupt (WFI) всегда передается на уровень EL1, поскольку это один из базовых примитивов планирования, используемых KVM.
Поддержка таймера
Значение компаратора для виртуального таймера должно быть доступно EL1 при каждом перехвате WFI, чтобы EL1 мог вводить прерывания таймера, пока vCPU заблокирован. Физический таймер полностью эмулируется, и все прерывания передаются в EL1.
Обработка MMIO
Чтобы взаимодействовать с монитором виртуальной машины (VMM) и выполнять эмуляцию GIC, перехваты MMIO должны передаваться обратно хосту в EL1 для дальнейшей сортировки. pKVM требует следующего:
- IPA и размер доступа
- Данные при записи
- Порядок байтов ЦП в момент перехвата
Кроме того, ловушки с регистром общего назначения в качестве источника или назначения передаются с помощью псевдорегистра абстрактной передачи.
Гостевые интерфейсы
Гостевая ОС может взаимодействовать с защищенной гостевой ОС, используя сочетание гипервызовов и доступа к памяти в перехваченных регионах. Гипервызовы предоставляются в соответствии со стандартом SMCCC, при этом диапазон, зарезервированный для распределения поставщиком, определяется KVM. Следующие гипервызовы особенно важны для гостевых ОС pKVM.
Общие гипервызовы
- PSCI предоставляет гостевой ОС стандартный механизм управления жизненным циклом виртуальных ЦП, включая их подключение, отключение и завершение работы системы.
- TRNG предоставляет гостевой ОС стандартный механизм для запроса энтропии у pKVM, который перенаправляет вызов в EL3. Этот механизм особенно полезен, когда хосту нельзя доверять виртуализацию аппаратного генератора случайных чисел (RNG).
Гипервызовы pKVM
- Обмен воспоминаниями с организатором. Память гостевой ОС изначально недоступна для хоста, но доступ хоста необходим для обмена данными через общую память и для паравиртуализированных устройств, которые используют общие буферы. Гипервызовы для предоставления и отмены доступа к страницам хосту позволяют гостевой ОС точно определять, какие части памяти будут доступны остальным компонентам Android, без необходимости подтверждения.
- Передача памяти хосту. Вся память гостевой системы обычно принадлежит ей до тех пор, пока она не будет уничтожена. Такое состояние может быть недостаточным для долгоживущих виртуальных машин с требованиями к памяти, которые меняются со временем. Гипервызов
relinquishпозволяет гостевой системе явно передать право собственности на страницы обратно хосту без необходимости завершения работы гостевой системы. - Перехват доступа к памяти хостом. Обычно, если гостевая ОС KVM обращается к адресу, который не соответствует действительному региону памяти, поток vCPU выходит на хост, и доступ обычно используется для MMIO и эмулируется VMM в пространстве пользователя. Чтобы упростить обработку, pKVM должна передавать хосту сведения о сбойной инструкции, например ее адрес, параметры регистра и, возможно, их содержимое. Если ловушка не была предусмотрена, это может привести к непреднамеренному раскрытию конфиденциальных данных из защищенной гостевой ОС. pKVM решает эту проблему, рассматривая такие сбои как критические, если гостевая ОС ранее не выполнила гипервызов, чтобы определить диапазон IPA, в котором разрешено перехватывать обращения к хосту. Это решение называется защитой MMIO.
Виртуальное устройство ввода-вывода (virtio)
Virtio – популярный, переносимый и зрелый стандарт для реализации паравиртуализированных устройств и взаимодействия с ними. Большинство устройств, доступных защищенным гостевым ОС, реализованы с помощью virtio. Virtio также лежит в основе реализации vsock, которая используется для связи между защищенным гостем и остальной частью Android.
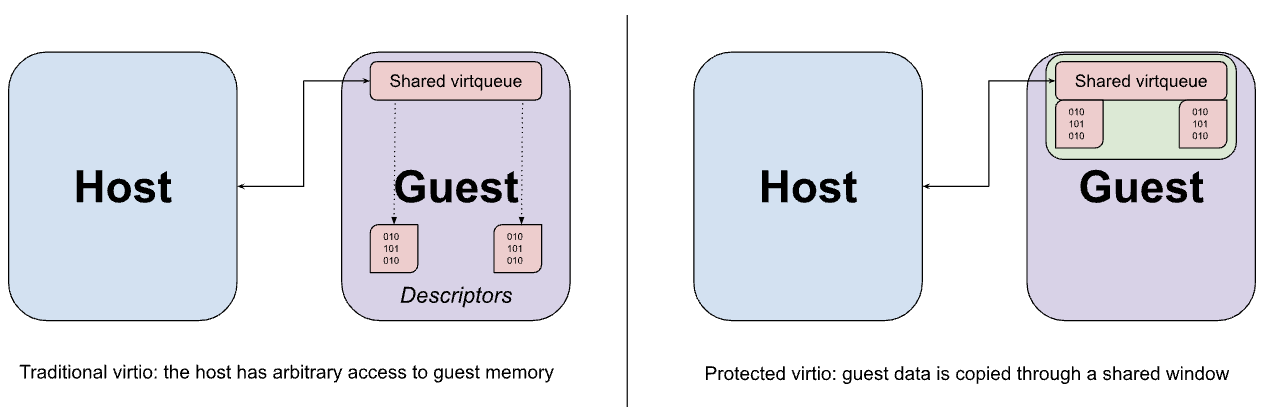
Устройства Virtio обычно реализуются в пользовательском пространстве хоста с помощью VMM, которая перехватывает обращения к памяти из гостевой системы к интерфейсу MMIO устройства virtio и эмулирует ожидаемое поведение. Доступ MMIO относительно дорог, поскольку каждый доступ к устройству требует двустороннего обмена данными с VMM и обратно, поэтому большая часть фактической передачи данных между устройством и гостем происходит с использованием набора виртуальных очередей в памяти. Ключевое допущение virtio заключается в том, что хост может произвольно получать доступ к памяти гостевой ОС. Это предположение очевидно в дизайне virtqueue, который может содержать указатели на буферы в гостевой системе, к которым эмуляция устройства должна иметь прямой доступ.
Хотя описанные выше гипервызовы для обмена памятью можно использовать для передачи буферов данных virtio из гостевой ОС в хост-ОС, такой обмен обязательно выполняется на уровне страниц и может привести к раскрытию большего объема данных, чем требуется, если размер буфера меньше размера страницы. Вместо этого гостевая система настраивается так, чтобы выделять и виртуальные очереди, и соответствующие им буферы данных из фиксированного окна общей памяти, а данные копируются (передаются) в окно и из него по мере необходимости.
Взаимодействие с TrustZone
Хотя гости не могут напрямую взаимодействовать с TrustZone, хост должен иметь возможность выполнять вызовы SMC в защищенную среду. Эти вызовы могут указывать на физически адресуемые буферы памяти, недоступные для хоста. Поскольку защищенное ПО обычно не знает о доступности буфера, вредоносный хост может использовать этот буфер для выполнения атаки типа "запутавшийся заместитель" (аналогично атаке DMA). Чтобы предотвратить такие атаки, pKVM перехватывает все вызовы SMC хоста к EL2 и действует как прокси-сервер между хостом и защищенным монитором на EL3.
Вызовы PSCI от хоста пересылаются во встроенное ПО EL3 с минимальными изменениями. В частности, точка входа для ЦП, который переходит в онлайн-режим или возобновляет работу после приостановки, переписывается таким образом, чтобы таблица страниц второго этапа устанавливалась на уровне EL2 до возврата к хосту на уровне EL1. Во время загрузки эта защита обеспечивается pKVM.
Эта архитектура опирается на поддержку PSCI в SoC, желательно с использованием актуальной версии TF-A в качестве встроенного ПО EL3.
Firmware Framework for Arm (FF-A) стандартизирует взаимодействие между обычной и защищенной средами, особенно при наличии защищенного гипервизора. Значительная часть спецификации определяет механизм обмена памятью с защищенной средой с использованием общего формата сообщений и четко определенной модели разрешений для базовых страниц. Прокси-сервер pKVM пересылает сообщения FF-A, чтобы убедиться, что хост не пытается предоставить защищенной стороне доступ к памяти, для которого у него нет достаточных разрешений.
Эта архитектура опирается на ПО безопасного мира, которое обеспечивает соблюдение модели доступа к памяти. Это гарантирует, что доверенные приложения и любое другое ПО, работающее в безопасном мире, могут получить доступ к памяти, только если она принадлежит исключительно безопасному миру или была явно предоставлена ему с помощью FF-A. В системе с S-EL2 модель доступа к памяти должна применяться ядром Secure Partition Manager (SPMC), например Hafnium, которое поддерживает таблицы страниц второго уровня для безопасной среды. В системе без S-EL2 доверенная среда исполнения может применять модель доступа к памяти через таблицы страниц первого уровня.
Если вызов SMC к EL2 не является вызовом PSCI или определенным FF-A сообщением, необработанные вызовы SMC перенаправляются к EL3. Предполагается, что безопасное встроенное ПО (которое должно быть доверенным) может безопасно обрабатывать необработанные SMC, поскольку оно знает, какие меры предосторожности необходимы для поддержания изоляции pVM.
Монитор виртуальной машины
crosvm – это монитор виртуальных машин (VMM), который запускает виртуальные машины через интерфейс KVM в Linux. Уникальность crosvm заключается в том, что он ориентирован на безопасность благодаря использованию языка программирования Rust и изолированной среды для виртуальных устройств, которая защищает ядро хоста. Подробнее о crosvm можно узнать из официальной документации здесь.
Дескрипторы файлов и ioctl
KVM предоставляет пользователям доступ к символьному устройству /dev/kvm с помощью ioctl, которые составляют KVM API. Ioctl относятся к следующим категориям:
- Системные ioctl запрашивают и задают глобальные атрибуты, которые влияют на всю подсистему KVM, и создают защищенные виртуальные машины.
- Ioctl виртуальной машины запрашивают и устанавливают атрибуты, которые создают виртуальные ЦП (vCPU) и устройства и влияют на всю pVM, например, включая макет памяти и количество виртуальных ЦП (vCPU) и устройств.
- ioctl виртуального ЦП запрашивают и задают атрибуты, которые управляют работой одного виртуального ЦП.
- Команды ioctl устройства позволяют запрашивать и задавать атрибуты, которые управляют работой одного виртуального устройства.
Каждый процесс crosvm запускает ровно один экземпляр виртуальной машины. В этом процессе используется системный вызов ioctl KVM_CREATE_VM для создания дескриптора файла виртуальной машины, который можно использовать для выполнения вызовов ioctl pVM. Команда ioctl KVM_CREATE_VCPU или KVM_CREATE_DEVICE, выполненная в отношении дескриптора файла ВМ, создает виртуальный ЦП или устройство и возвращает дескриптор файла, указывающий на новый ресурс. Команды ioctl, выполненные в отношении дескриптора файла виртуального ЦП или устройства, можно использовать для управления устройством, созданным с помощью команды ioctl, выполненной в отношении дескриптора файла ВМ. Для виртуальных процессоров это включает важную задачу выполнения гостевого кода.
Внутренне crosvm регистрирует дескрипторы файлов ВМ в ядре, используя интерфейс epoll с триггером по фронту. Затем ядро уведомляет crosvm, когда в любом из дескрипторов файлов появляется новое ожидающее событие.
pKVM добавляет новую возможность – KVM_CAP_ARM_PROTECTED_VM, которую можно использовать для получения информации о среде pVM и настройки защищенного режима для виртуальной машины. crosvm использует ее при создании pVM, если передан флаг --protected-vm, чтобы запросить и зарезервировать необходимый объем памяти для встроенного ПО pVM, а затем включить защищенный режим.
Выделение памяти
Одна из основных обязанностей VMM – выделять память для виртуальной машины и управлять ее структурой. crosvm создает фиксированную структуру памяти, которая в общих чертах описана в таблице ниже.
| FDT в обычном режиме | PHYS_MEMORY_END - 0x200000
|
| Освободить место | ...
|
| Ramdisk | ALIGN_UP(KERNEL_END, 0x1000000)
|
| Kernel | 0x80080000
|
| Загрузчик | 0x80200000
|
| FDT в режиме BIOS | 0x80000000
|
| Базовый адрес физической памяти | 0x80000000
|
| Встроенное ПО pVM | 0x7FE00000
|
| Память | 0x10000 - 0x40000000
|
Физическая память выделяется с помощью mmap, а затем передается виртуальной машине для заполнения областей памяти, называемых слотами памяти, с помощью ioctl KVM_SET_USER_MEMORY_REGION. Таким образом, вся память гостевой ВМ pVM относится к экземпляру crosvm, который ею управляет. Если на хосте заканчивается свободная память, процесс может быть завершен (ВМ будет остановлена). Когда виртуальная машина останавливается, гипервизор автоматически очищает память и возвращает ее ядру хоста.
В обычной KVM у VMM есть доступ ко всей памяти гостевой ОС. При использовании pKVM память гостевой ОС отменяется из физического адресного пространства хоста, когда она передается гостевой ОС. Единственное исключение – память, которой гостевая система явно делится с хостом, например для устройств virtio.
Области MMIO в адресном пространстве гостя остаются без сопоставления. Доступ гостевой ОС к этим регионам перехватывается и приводит к событию I/O в дескрипторе файла виртуальной машины. Этот механизм используется для реализации виртуальных устройств. В защищенном режиме гостевая ОС должна подтвердить, что область ее адресного пространства используется для MMIO, с помощью гипервызова. Это позволяет снизить риск случайной утечки информации.
Планирование
Каждый виртуальный ЦП представлен потоком POSIX и планируется планировщиком хоста Linux. Поток вызывает KVM_RUN ioctl на дескрипторе файла ВЦП, в результате чего гипервизор переключается на контекст гостевой ВЦП. Планировщик хоста учитывает время, проведенное в контексте гостя, как время, использованное соответствующим потоком vCPU. KVM_RUN возвращается, когда происходит событие, которое должен обработать VMM, например I/O, конец прерывания или остановка виртуального ЦП. Менеджер виртуальных машин обрабатывает событие и снова вызывает KVM_RUN.
Во время KVM_RUN поток может быть прерван планировщиком хоста, за исключением выполнения кода гипервизора EL2, который не может быть прерван. У гостевой pVM нет механизма для управления этим поведением.
Поскольку все потоки vCPU планируются как и любые другие задачи пользовательского пространства, к ним применяются все стандартные механизмы QoS. В частности, каждый поток vCPU можно привязать к физическим процессорам, поместить в cpusets, ускорить или ограничить с помощью фиксации использования, изменить его приоритет или политику планирования и т. д.
Виртуальные устройства
crosvm поддерживает ряд устройств, в том числе:
- virtio-blk для составных образов дисков, доступных только для чтения или для чтения и записи.
- vhost-vsock для связи с хостом
- virtio-pci в качестве транспорта virtio
- pl030 real time clock (RTC)
- UART 16550a для последовательной передачи данных
Встроенное ПО pVM
Прошивка pVM (pvmfw) – это первый код, выполняемый pVM, аналогично загрузочному ПЗУ физического устройства. Основная цель pvmfw – запустить безопасную загрузку и получить уникальный секрет pVM. pvmfw можно использовать с любой ОС, поддерживаемой crosvm и имеющей действительную подпись, а не только с Microdroid.
Двоичный файл pvmfw хранится в разделе флеш-памяти с тем же названием и обновляется с помощью OTA.
Загрузка устройства
В процедуру загрузки устройства с поддержкой pKVM добавляется следующая последовательность действий:
- Загрузчик Android (ABL) загружает pvmfw из раздела в память и проверяет образ.
- Загрузчик ABL получает секреты Device Identifier Composition Engine (DICE) (идентификаторы составных устройств (CDI) и цепочку сертификатов DICE) от корня доверия.
- ABL извлекает необходимые CDI для pvmfw и добавляет их в двоичный файл pvmfw.
- Загрузчик Android добавляет в ДУ узел зарезервированной области памяти
linux,pkvm-guest-firmware-memory, описывающий расположение и размер исполняемого файла pvmfw и секретов, полученных на предыдущем шаге. - ABL передает управление Linux, и Linux инициализирует pKVM.
- pKVM отменяет сопоставление области памяти pvmfw с таблицами страниц второго уровня хоста и защищает ее от хоста и гостевых систем в течение всего времени работы устройства.
После загрузки устройства Microdroid загружается в соответствии с инструкциями в разделе Последовательность загрузки документа Microdroid.
Загрузка pVM
При создании защищенной виртуальной машины crosvm (или другой диспетчер виртуальных машин) должен создать достаточно большой слот памяти, чтобы гипервизор мог заполнить его образом pvmfw. Кроме того, VMM может задавать начальные значения только для определенных регистров (x0–x14 для основного виртуального ЦП и ни одного для дополнительных виртуальных ЦП). Остальные регистры зарезервированы и являются частью ABI гипервизора pvmfw.
При запуске pVM гипервизор сначала передает управление основным vCPU в pvmfw. Встроенное ПО ожидает, что crosvm загрузит ядро, подписанное AVB (это может быть загрузчик операционной системы или любой другой образ), и неподписанное дерево устройств в память с известными смещениями. pvmfw проверяет подпись AVB и, если она действительна, генерирует доверенное дерево устройств на основе полученного дерева устройств, удаляет свои секреты из памяти и переходит к точке входа полезной нагрузки. Если один из шагов проверки не пройден, встроенное ПО выполняет гипервызов PSCI SYSTEM_RESET.
Между загрузками информация об экземпляре pVM хранится в разделе (устройство virtio-blk) и шифруется с помощью секрета pvmfw, чтобы после перезагрузки секрет был предоставлен правильному экземпляру.