

systrace – основной инструмент для анализа производительности устройств Android. Однако на самом деле это оболочка для других инструментов. Это оболочка на стороне хоста для atrace – исполняемого файла на стороне устройства, который управляет трассировкой пространства пользователя и настраивает ftrace, а также основной механизм трассировки в ядре Linux. Systrace использует atrace для включения трассировки, затем считывает буфер ftrace и упаковывает все это в автономное средство просмотра HTML. (Более новые ядра поддерживают расширенный пакетный фильтр Berkeley для Linux (eBPF), но на этой странице речь идет о ядре 3.18 (без eBPF), поскольку оно использовалось на Pixel и Pixel XL.)
systrace принадлежит командам Google Android и Google Chrome и является ПО с открытым исходным кодом в рамках Catapult. Помимо systrace, в Catapult входят и другие полезные утилиты. Например, ftrace имеет больше функций, чем можно напрямую включить с помощью systrace или atrace, и содержит некоторые расширенные функции, которые имеют решающее значение для отладки проблем с производительностью. (Для этих функций требуются права root и часто новое ядро.)
Как запустить systrace
При отладке дрожания на Pixel или Pixel XL начните со следующей команды:
./systrace.py sched freq idle am wm gfx view sync binder_driver irq workq input -b 96000
В сочетании с дополнительными точками трассировки, необходимыми для графического процессора и конвейера отображения, это позволяет отслеживать путь от ввода данных пользователем до отображения кадра на экране. Установите большой размер буфера, чтобы избежать потери событий (поскольку без большого буфера некоторые процессоры не содержат событий после определенной точки трассировки).
При анализе отчета systrace помните, что каждое событие запускается процессом в ЦП.
Поскольку systrace построен на основе ftrace, а ftrace работает на ЦП, что-то на ЦП должно записывать буфер ftrace, который регистрирует изменения оборудования. Это означает, что если вам интересно, почему изменилось состояние забора дисплея, вы можете увидеть, что работало на ЦП в точный момент его перехода (что-то, работающее на ЦП, вызвало это изменение в журнале). Это понятие лежит в основе анализа производительности с помощью systrace.
Пример: "Рабочая рамка"
В этом примере описывается systrace для обычного конвейера интерфейса. Чтобы повторить действия из примера, скачайте ZIP-файл с трассировками (в нем также есть другие трассировки, упомянутые в этом разделе), распакуйте его и откройте файл systrace_tutorial.html в браузере.
При постоянной периодической рабочей нагрузке, например TouchLatency, конвейер интерфейса следует следующей последовательности:
- EventThread в SurfaceFlinger пробуждает поток UI приложения, сигнализируя о том, что пришло время отрисовать новый кадр.
- Приложение обрабатывает фрейм в потоке UI, RenderThread и задачах HWUI, используя ресурсы ЦП и графического процессора. Именно на него приходится большая часть использованной квоты.
- Приложение отправляет отрисованный фрейм в SurfaceFlinger с помощью связующего объекта, после чего SurfaceFlinger переходит в спящий режим.
- Второй поток EventThread в SurfaceFlinger активирует SurfaceFlinger, чтобы запустить композицию и вывод на экран. Если SurfaceFlinger определяет, что работы нет, он снова переходит в спящий режим.
- SurfaceFlinger выполняет композицию с помощью Hardware Composer (HWC), Hardware Composer 2 (HWC2) или GL. Композиция HWC и HWC2 выполняется быстрее и потребляет меньше энергии, но имеет ограничения в зависимости от системы на кристалле (SoC). Обычно это занимает от 4 до 6 мс, но может пересекаться с шагом 2, поскольку в приложениях для Android всегда используется тройная буферизация. (Хотя приложения всегда используют тройную буферизацию, в SurfaceFlinger может быть только один ожидающий кадр, из-за чего это будет выглядеть как двойная буферизация.)
- SurfaceFlinger отправляет конечный результат на дисплей с помощью драйвера поставщика и переходит в спящий режим, ожидая пробуждения EventThread.
Вот пример последовательности кадров, начинающейся с 15 409 мс:

Рисунок 1. Обычный процесс интерфейса, запущен EventThread.
На рисунке 1 показан обычный кадр, окруженный обычными кадрами, поэтому он хорошо подходит для того, чтобы понять, как работает конвейер пользовательского интерфейса. Строка потока UI для TouchLatency включает разные цвета в разное время. Полосы обозначают разные состояния цепочки:
- Серый. Сплю.
- Синий. Готов к выполнению (может быть запущен, но планировщик ещё не выбрал его).
- Зеленый. Активно выполняется (планировщик считает, что оно выполняется).
- Красный. Непрерываемый сон (обычно сон на блокировке в ядре). Может указывать на нагрузку ввода-вывода. Очень полезно для отладки проблем производительности.
- Orange. Непрерываемый сон из-за нагрузки на ввод-вывод.
Чтобы узнать причину непрерываемого сна (доступно в точке трассировки sched_blocked_reason), выберите красный фрагмент непрерываемого сна.
Пока выполняется EventThread, поток UI для TouchLatency становится доступным для выполнения. Чтобы узнать, что его разбудило, нажмите на синий раздел.

Рисунок 2. Поток UI для TouchLatency.
На рисунке 2 показано, что поток UI TouchLatency был разбужен потоком с идентификатором 6843, который соответствует EventThread. Поток UI активируется, отрисовывает кадр и ставит его в очередь для SurfaceFlinger.

Рисунок 3. Поток UI активируется, отрисовывает кадр и ставит его в очередь для SurfaceFlinger.
Если в трассировке включен тег binder_driver, вы можете выбрать транзакцию Binder, чтобы посмотреть информацию обо всех процессах, связанных с ней.

Рисунок 4. Транзакция брошюратора.
На рисунке 4 показано, что в 15 423,65 мс Binder:6832_1 в SurfaceFlinger становится исполняемым из-за tid 9579, который является RenderThread TouchLatency. Кроме того, вы можете увидеть queueBuffer с обеих сторон транзакции Binder.
Во время queueBuffer на стороне SurfaceFlinger количество ожидающих кадров из TouchLatency увеличивается с 1 до 2.

Рисунок 5. Количество ожидающих обработки кадров увеличивается с 1 до 2.
На рисунке 5 показана тройная буферизация, при которой есть два готовых кадра и приложение собирается начать отрисовку третьего. Это связано с тем, что мы уже пропустили несколько кадров, поэтому приложение сохраняет два ожидающих кадра вместо одного, чтобы избежать дальнейших пропусков.
Вскоре после этого основной поток SurfaceFlinger пробуждается вторым EventThread, чтобы вывести на экран более старый ожидающий кадр:

Рисунок 6. Основной поток SurfaceFlinger пробуждается вторым EventThread.
Сначала SurfaceFlinger блокирует старый ожидающий буфер, в результате чего количество ожидающих буферов уменьшается с 2 до 1:

Рисунок 7. SurfaceFlinger сначала прикрепляется к более старому ожидающему буферу.
После фиксации буфера SurfaceFlinger настраивает композицию и отправляет финальный кадр на дисплей. (Некоторые из этих разделов включены как часть mdss точки трассировки, поэтому они могут не быть включены в вашу SoC.)

Рисунок 8. SurfaceFlinger настраивает композицию и отправляет финальный кадр.
Затем mdss_fb0 пробуждается на ЦП 0. mdss_fb0 – это поток ядра конвейера дисплея, который выводит отрисованный кадр на экран.
Обратите внимание, что mdss_fb0 находится в отдельной строке трассировки (прокрутите вниз, чтобы посмотреть):

Рис. 9. Процесс mdss_fb0 возобновляет работу на ядре ЦП 0.
mdss_fb0 просыпается, работает некоторое время, переходит в режим непрерываемого сна, а затем снова просыпается.
Пример: неработающий фрейм
В этом примере описывается, как использовать systrace для отладки дрожания на устройствах Pixel или Pixel XL. Чтобы повторить действия из примера, скачайте ZIP-файл с трассировками (включая другие трассировки, упомянутые в этом разделе), распакуйте его и откройте файл systrace_tutorial.html в браузере.
Когда вы откроете файл systrace, вы увидите что-то похожее на изображение ниже.

Рисунок 10. TouchLatency на Pixel XL с большинством включенных параметров.
На рисунке 10 большинство параметров включено, в том числе точки трассировки mdss и kgsl.
При поиске рывков проверьте строку FrameMissed в разделе SurfaceFlinger.
FrameMissed – это улучшение качества жизни, предоставляемое HWC2. При просмотре systrace для других устройств строка FrameMissed может отсутствовать, если устройство не использует HWC2. В обоих случаях FrameMissed коррелирует с тем, что SurfaceFlinger пропустил один из своих регулярных периодов выполнения, и с неизменным количеством буферов, ожидающих обработки приложением (com.prefabulated.touchlatency), при VSync.

Рисунок 11. Корреляция FrameMissed с SurfaceFlinger.
На рисунке 11 показан пропущенный кадр в 15598,29 мс.SurfaceFlinger ненадолго проснулся в интервале VSync и снова заснул, ничего не сделав. Это означает, что SurfaceFlinger решил, что не стоит пытаться снова отправить кадр на дисплей.
Чтобы понять, почему конвейер сломался на этом кадре, сначала посмотрите на пример работающего кадра выше и узнайте, как выглядит нормальный конвейер пользовательского интерфейса в systrace. Когда будете готовы, вернитесь к пропущенному кадру и двигайтесь назад. Обратите внимание, что SurfaceFlinger просыпается и сразу же переходит в спящий режим. При просмотре количества ожидающих кадров в TouchLatency обнаруживается два кадра (это хороший способ понять, что происходит).
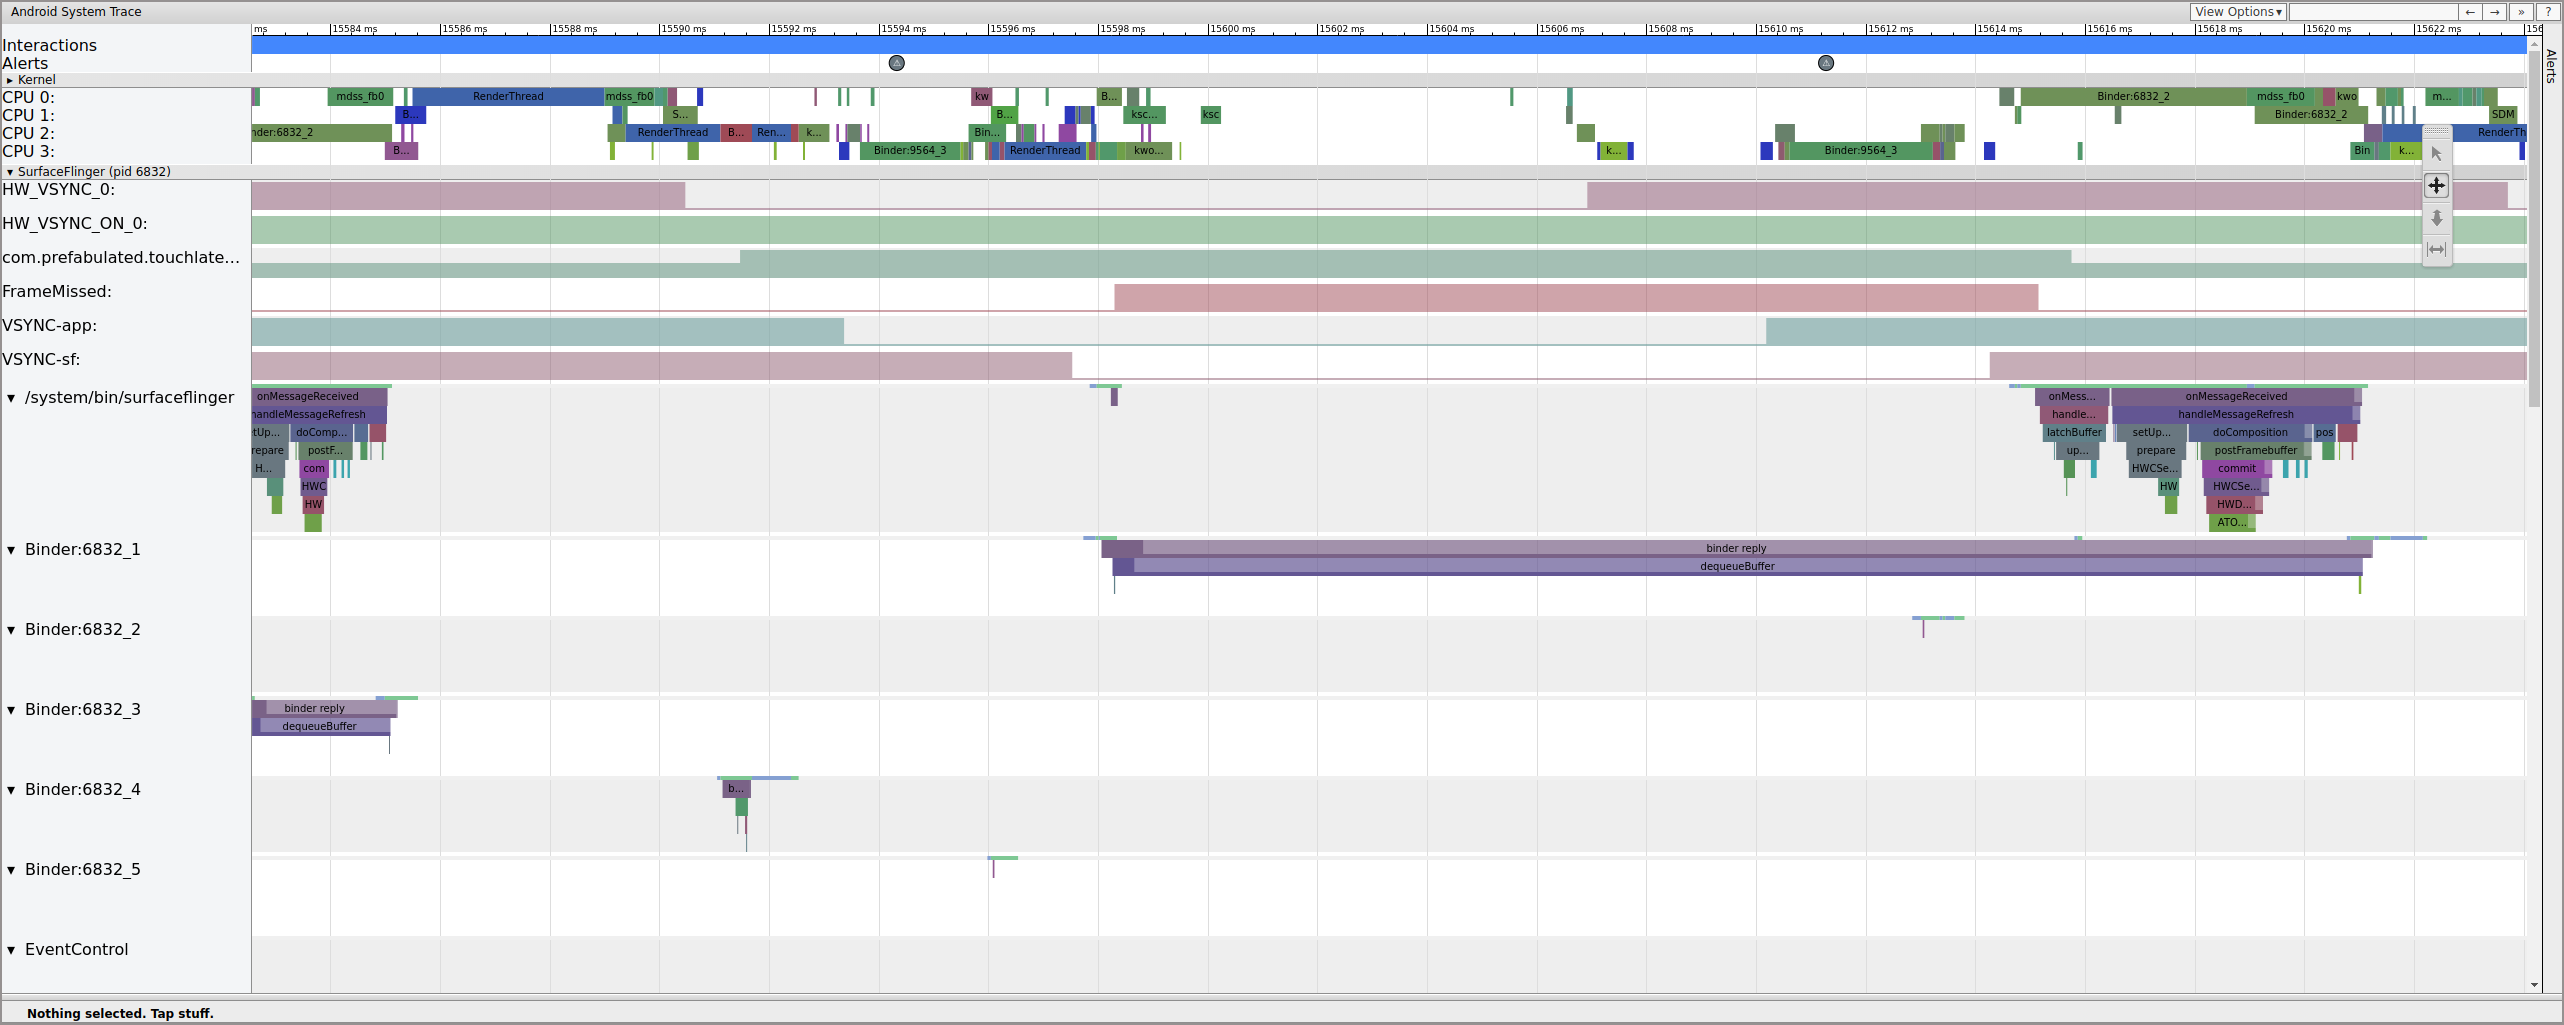
Рисунок 12. SurfaceFlinger просыпается и сразу же засыпает.
Поскольку в SurfaceFlinger есть кадры, проблема не в приложении. Кроме того, SurfaceFlinger просыпается в нужное время, поэтому проблема не связана с ним. Если с SurfaceFlinger и приложением все в порядке, скорее всего, проблема в драйвере.
Поскольку точки трассировки mdss и sync включены, вы можете получать информацию об ограждениях (которые используются совместно драйвером дисплея и SurfaceFlinger) и контролировать, когда кадры отправляются на дисплей.
Эти ограждения перечислены в разделе mdss_fb0_retire, который указывает, когда кадр находится на экране. Эти ограждения предоставляются в рамках категории трассировки sync. Какие ограждения соответствуют определенным событиям в SurfaceFlinger, зависит от вашей системы на кристалле и стека драйверов, поэтому обратитесь к поставщику системы на кристалле, чтобы понять значение категорий ограждений в ваших трассировках.

Рисунок 13. Ограждения mdss_fb0_retire.
На рисунке 13 показан кадр, который отображался 33 мс, а не 16,7 мс, как ожидалось. В середине этого фрагмента кадр должен был быть заменен на новый, но этого не произошло. Посмотреть предыдущий кадр и найти что-нибудь.

Рисунок 14. Кадр, предшествующий поврежденному кадру.
На рисунке 14 показан кадр длительностью 14,482 мс. Длительность поврежденного сегмента из двух кадров составила 33,6 мс, что примерно соответствует ожидаемому значению для двух кадров (отрисованных с частотой 60 Гц, 16,7 мс на кадр). Однако 14,482 мс – это не 16,7 мс, поэтому можно предположить, что с конвейером дисплея что-то не так.
Выясните, где именно заканчивается забор, чтобы определить, что его контролирует:

Рисунок 15. Проверьте конец ограждения.
Рабочая очередь содержит __vsync_retire_work_handler, который выполняется при изменении ограждения. Изучив исходный код ядра, вы увидите, что это часть драйвера дисплея. Похоже, что она находится на критическом пути для конвейера показа, поэтому ее нужно выполнить как можно быстрее. Она может выполняться около 70 мкс (небольшая задержка планирования), но это рабочая очередь, поэтому планирование может быть неточным.
Проверьте предыдущий кадр, чтобы определить, не повлиял ли он на проблему. Иногда дрожание может накапливаться со временем и в конечном итоге привести к пропуску срока.

Рисунок 16. Предыдущий кадр.
Выполняемая строка в kworker не видна, потому что при выборе она становится белой, но статистика говорит сама за себя: задержка планировщика в 2,3 мс для части критического пути конвейера дисплея – это плохо.
Прежде чем продолжить, устраните задержку, перенеся эту часть критического пути конвейера обработки изображений из рабочей очереди (которая выполняется как поток SCHED_OTHER CFS) в выделенный поток ядра SCHED_FIFO. Для этой функции требуются гарантии времени, которые рабочие очереди не могут (и не должны) предоставлять.
Неясно, является ли это причиной рывков. В случаях, когда проблема легко диагностируется, например когда из-за конфликта блокировок ядра потоки, критически важные для работы дисплея, переходят в спящий режим, трассировки обычно не указывают на проблему. Возможно, именно из-за этого дрожания был пропущен кадр. Время ограждения должно составлять 16,7 мс, но в кадрах, предшествующих пропущенному, оно далеко от этого значения. Поскольку конвейер обработки изображений тесно связан, возможно, дрожание временных меток привело к пропуску кадра.
В этом примере решение включает преобразование __vsync_retire_work_handler из рабочей очереди в выделенный kthread. Это приводит к заметному улучшению стабильности и уменьшению рывков при тестировании с помощью подпрыгивающего мяча. В последующих трассировках время ожидания ограждения очень близко к 16,7 мс.