

Чтобы панель непрерывной интеграции была масштабируемой, производительной и гибкой, необходимо тщательно спроектировать ее серверную часть, хорошо понимая, как работают базы данных. Google Cloud Datastore – это база данных NoSQL, которая гарантирует транзакционную ACID и согласованность в конечном счете, а также полную согласованность в группах объектов. Однако его структура сильно отличается от баз данных SQL (и даже Cloud Bigtable): вместо таблиц, строк и ячеек в нем используются виды, объекты и свойства.
В следующих разделах описаны структура данных и шаблоны запросов, которые помогут вам создать эффективный серверный компонент для веб-сервиса панели инструментов VTS.
Объекты
В следующих объектах хранятся сводки и ресурсы, полученные в результате выполнения тестов VTS:
- Тестовый объект. Хранит метаданные о тестовых запусках определенного теста. Ключом является название теста, а свойства включают количество сбоев, количество успешных выполнений и список сбоев в тестовых сценариях, полученный при обновлении заданий оповещений.
- Объект тестового запуска. Содержит метаданные из результатов определенного теста. В нем должны храниться временные метки начала и окончания теста, идентификатор тестовой сборки, количество пройденных и не пройденных отчетов о тестировании, тип запуска (например, предварительный, после отправки или локальный), список ссылок на журналы, название хост-компьютера и сводные данные о покрытии.
- Объект "Информация об устройстве". Содержит сведения об устройствах, использованных во время тестового запуска. Он включает идентификатор сборки устройства, название продукта, целевую сборку, ветку и информацию об ABI. Эти данные хранятся отдельно от объекта тестового запуска, чтобы поддерживать тестовые запуски на нескольких устройствах в формате "один ко многим".
- Profiling Point Run Entity. Обобщает данные, собранные для определенной точки профилирования в рамках тестового запуска. В нем описаны метки осей, название точки профилирования, значения, тип и режим регрессии данных профилирования.
- Объект покрытия. Описывает данные об охвате, собранные для одного файла. Он содержит информацию о проекте Git, путь к файлу и список значений покрытия для каждой строки в исходном файле.
- Объект выполнения тестового случая. Описывает результат выполнения определенного тестового случая из тестового прогона, включая название тестового случая и его результат.
- Объект избранного пользователя. Каждую подписку пользователя можно представить в виде объекта, содержащего ссылку на тест и идентификатор пользователя, сгенерированный сервисом пользователей App Engine. Это позволяет эффективно выполнять двусторонние запросы (например, для всех пользователей, подписанных на тест, и для всех тестов, добавленных пользователем в избранное).
Группировка объектов
Каждый тестовый модуль представляет собой корень группы объектов. Объекты тестового запуска являются дочерними по отношению к этой группе и родительскими по отношению к объектам устройств, точкам профилирования и объектам покрытия, относящимся к соответствующему тесту и родительскому тестовому запуску.

Важно! При проектировании отношений предков необходимо найти баланс между эффективными и согласованными механизмами запросов и ограничениями, накладываемыми базой данных.
Преимущества
Требование согласованности гарантирует, что будущие операции не будут видеть эффекта транзакции до ее фиксации, а транзакции в прошлом будут видны текущим операциям. В Cloud Datastore группировка объектов создает островки строгой согласованности чтения и записи в группе, которая в данном случае представляет собой все тестовые запуски и данные, связанные с тестовым модулем. Это дает следующие преимущества:
- Операции чтения и обновления состояния модуля тестирования, выполняемые заданиями оповещений, можно считать атомарными.
- Гарантированный единообразный просмотр результатов тестовых случаев в тестовых модулях.
- Более быстрый поиск по деревьям наследования.
Ограничения
Не рекомендуется записывать в группу объектов более одного объекта в секунду, так как некоторые записи могут быть отклонены. Если задания оповещений и загрузка выполняются не чаще одного раза в секунду, структура будет надежной и обеспечит полную согласованность.
Ограничение в одну запись в секунду на тестовый модуль является разумным, поскольку выполнение тестов обычно занимает не менее одной минуты, включая накладные расходы на фреймворк VTS. Узкое место в записи может возникнуть, только если тест постоянно выполняется одновременно на более чем 60 разных хостах. Это становится ещё менее вероятным, учитывая, что каждый модуль является частью плана тестирования, который часто занимает больше часа. Аномалии легко устранить, если хосты выполняют тесты одновременно, что приводит к кратковременным всплескам записи на одни и те же хосты (например, при обнаружении ошибок записи и повторных попытках).
Масштабирование
Тестовый запуск не обязательно должен быть дочерним элементом теста (например, он может использовать другой ключ и иметь такие свойства, как название теста и время начала теста). Однако в этом случае строгая согласованность будет заменена на согласованность в конечном счете. Например, задание оповещения может не увидеть согласованный снимок последних запусков тестов в модуле тестирования, а значит, глобальное состояние может не полностью отражать последовательность запусков тестов. Это также может повлиять на отображение тестовых запусков в одном тестовом модуле, который не обязательно будет представлять собой последовательность запусков. В конечном итоге снимок будет согласован, но нет гарантии, что в нем будут самые свежие данные.
Отчеты о тестировании
Ещё одна потенциальная проблема – большие тесты с множеством тестовых сценариев. Два действующих ограничения: максимальная пропускная способность записи в группе объектов составляет один объект в секунду, а максимальный размер транзакции – 500 объектов.
Один из способов – указать тестовый случай, у которого в качестве предка есть тестовый прогон (аналогично тому, как хранятся данные о покрытии, профилировании и устройстве):

Хотя такой подход обеспечивает атомарность и согласованность, он накладывает серьезные ограничения на тесты: если транзакция ограничена 500 объектами, то тест может содержать не более 498 тестовых случаев (при условии отсутствия данных о покрытии или профилировании). Если тест превысит это значение, то одна транзакция не сможет записать все отчеты о тестировании одновременно, а разделение отчетов о тестировании на отдельные транзакции может превысить максимальную пропускную способность записи группы объектов в одну итерацию в секунду. Это решение не рекомендуется, так как оно не масштабируется без ущерба для производительности.
Однако вместо того, чтобы хранить результаты тестовых случаев как дочерние элементы тестового запуска, тестовые случаи можно хранить независимо, а их ключи предоставлять тестовому запуску (тестовый запуск содержит список идентификаторов для его объектов тестовых случаев):
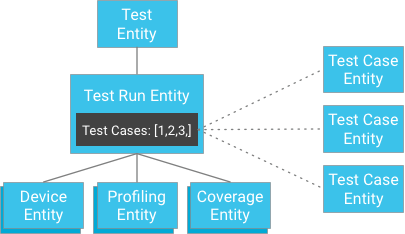
На первый взгляд может показаться, что это нарушает гарантию строгой согласованности. Однако если у клиента есть объект тестового запуска и список идентификаторов тестовых случаев, ему не нужно создавать запрос; вместо этого он может напрямую получить тестовые случаи по их идентификаторам, что всегда гарантирует согласованность. Такой подход значительно снижает ограничение на количество тестовых сценариев, которые могут быть в тестовом запуске, и обеспечивает полную согласованность без риска чрезмерной записи в группе объектов.
Шаблоны доступа к данным
На панели мониторинга VTS используются следующие шаблоны доступа к данным:
- Избранное пользователя. Можно запросить, используя фильтр равенства для объектов избранного пользователя, у которых определенный объект пользователя App Engine является свойством.
- Тестовая страница. Простой запрос тестовых объектов. Чтобы уменьшить пропускную способность для рендеринга главной страницы, можно использовать проекцию на количество пройденных и непройденных тестов, чтобы опустить потенциально длинный список идентификаторов непройденных тестов и других метаданных, используемых заданиями оповещения.
- Тестовые запуски. Для запроса объектов тестового запуска требуется сортировка по ключу (временной метке) и возможная фильтрация по свойствам тестового запуска, таким как идентификатор сборки, количество проходов и т. д. При выполнении запроса к предку с ключом тестового объекта чтение полностью согласовано. На этом этапе все результаты тестовых случаев можно получить с помощью списка идентификаторов, хранящегося в свойстве тестового запуска. Это также гарантирует согласованность результатов благодаря операциям получения данных из хранилища.
- Данные профилирования и покрытия. Запрос данных профилирования или покрытия, связанных с тестом, можно выполнить без получения других данных о выполнении теста (например, других данных профилирования/покрытия, данных тестовых случаев и т. д.). Запрос к предку с использованием ключей объектов test и test run позволит получить все точки профилирования, записанные во время тестового запуска. Если также отфильтровать по имени точки профилирования или названию файла, можно получить отдельный объект профилирования или покрытия. Поскольку запросы к предкам являются согласованными, эта операция также является согласованной.
Подробную информацию об интерфейсе и скриншоты шаблонов данных в действии можно найти в статье Интерфейс панели управления VTS.